Binariks engineered a hybrid cloud data platform that fundamentally transformed how the bank processes, secures, and derives value from data.
Core Architecture
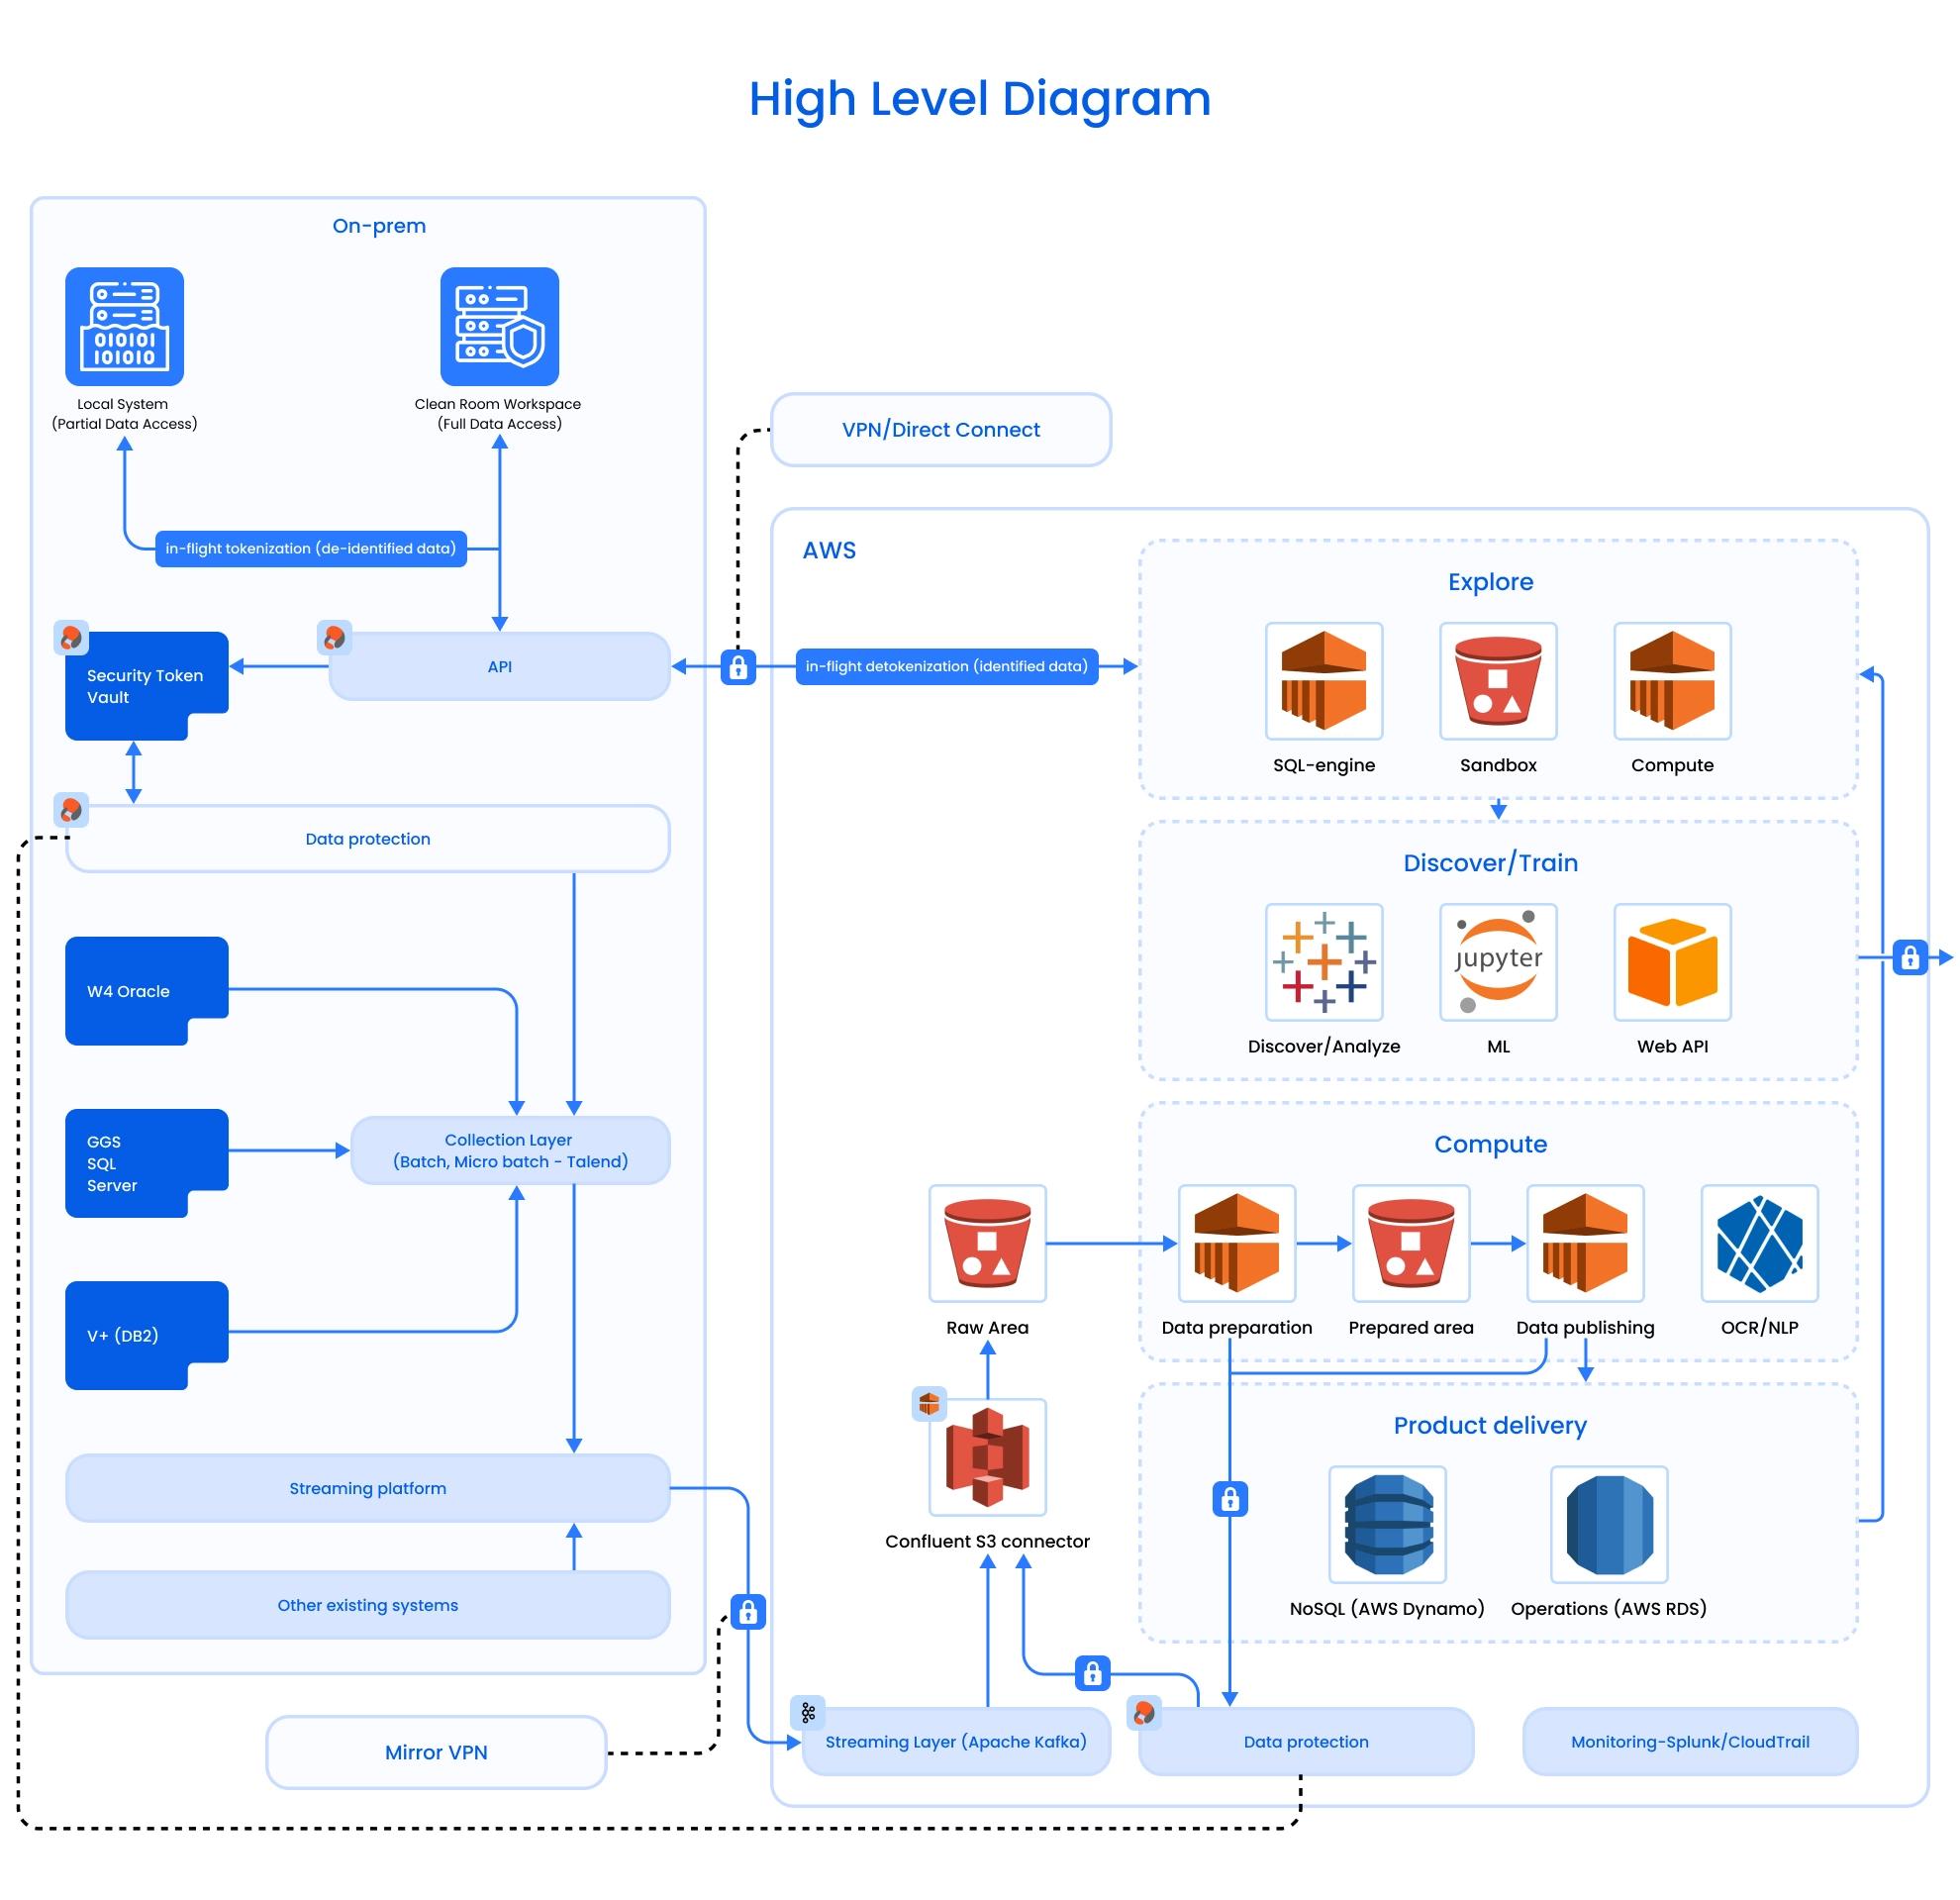
Hybrid cloud with intelligent data segregation:
- Cloud layer (AWS): Non-sensitive and de-identified data processed using S3 data lakes, EMR (Apache Spark) for distributed processing, RDS for structured storage, and DynamoDB for high-throughput metadata management
- On-premises layer: Sensitive data (PII, card numbers, account details) secured within Protegrity's tokenization vault
- Unified access layer: Single logical data view for business users, abstracting physical location complexity
Real-time tokenization for compliance and utility:
- Implemented Protegrity for low-latency (<50ms) tokenization of sensitive fields before cloud transmission
- Format-preserving encryption maintained data utility – analysts could join, filter, and analyze without accessing raw sensitive values
- Secure on-demand de-tokenization in memory for authorized users when business context required original values
- Enabled seamless joining of cloud-based analytical datasets with on-premises sensitive data without compromising regulatory compliance
Cloud-native data processing:
- Migrated compute-intensive workloads (machine learning training, batch analytics, BI queries) from legacy Oracle to AWS EMR with Apache Spark
- Implemented scalable streaming ingestion via Kafka for near real-time transaction processing
- Deployed containerized microservices on Kubernetes for elastic scaling and hybrid portability
- Introduced Presto query engine for fast, cost-efficient ad-hoc SQL queries across S3 data lakes
Unified data governance framework:
- Established enterprise-wide data catalog with standardized business attribute definitions – eliminating the conflicting interpretations that plagued decision-making
- Implemented role-based access control (RBAC) with consistent security policies across hybrid environments
- Created automated data lineage tracking and audit trails for regulatory compliance (PCI-DSS, GDPR principles, AML/KYC)
- Data governance council established with ongoing stewardship processes
Self-service analytics enablement:
- Deployed curated, governed datasets accessible via Tableau dashboards and Jupyter notebooks
- Business analysts query pre-processed data independently – no IT tickets, no weeks-long delays
- Data scientists gained secure sandbox environments with tokenized production data for model development
- 200+ business users now generate insights in minutes instead of submitting requests and waiting days
DevOps transformation:
- CI/CD automation: Jenkins pipelines replaced manual, error-prone deployments. Blue-green deployment strategies enabled zero-downtime releases
- Infrastructure as Code: Terraform modules made infrastructure provisioning repeatable, version-controlled, and peer-reviewed. Provisioning time dropped from weeks to hours
- Container orchestration: Kubernetes enabled consistent deployments across on-premises and cloud with auto-scaling and self-healing capabilities
- Observability: Centralized logging (Splunk) and monitoring (CloudWatch) replaced fragmented tooling. Distributed tracing identified performance bottlenecks before they impacted users
- Secrets management: HashiCorp Vault centralized API keys, credentials, and certificates with dynamic secrets and audit logging
Technology Selection
AWS as cloud platform: Regional data center presence met regulatory requirements. Mature service ecosystem (S3, EMR, RDS, DynamoDB) and existing bank vendor relationship reduced adoption risk. PCI-DSS and ISO 27001 certifications satisfied compliance teams.
Protegrity for tokenization: Real-time performance was non-negotiable. Format-preserving encryption maintained data utility for analytics. Reversible tokenization allowed authorized de-tokenization when needed. Proven banking deployments reduced implementation risk.
Apache Spark on EMR: Scalable distributed processing for big data workloads. Cost-effective compared to proprietary tools. Python support aligned with data science team capabilities. Mature ecosystem with extensive community support.
Kafka for streaming: High-throughput, fault-tolerant real-time ingestion. Industry standard with extensive connector ecosystem. Enabled near real-time analytics replacing batch-only legacy processes.
Kubernetes: Container orchestration for hybrid portability. Enabled microservices architecture with declarative configuration, auto-scaling, and self-healing. Industry standard reducing vendor lock-in concerns.
Phased Implementation
- Phase 1 - Discovery & Architecture Design (6 months): Comprehensive assessment, hybrid architecture design, AWS foundation setup, Protegrity selection, data governance framework definition
- Phase 2 - Infrastructure Foundation (6 months): AWS infrastructure provisioning (S3, EMR, RDS, VPCs), Protegrity vault deployment, secure connectivity establishment (AWS Direct Connect), CI/CD pipeline implementation (Jenkins, Terraform), monitoring setup (Splunk, CloudWatch)
- Phase 3 - MVP: Card Issuing Analytics (7 months): First production use case – migrated card issuing transaction data from Oracle to AWS with tokenization, built Spark-based ETL pipelines, deployed Tableau dashboards, established self-service Jupyter environments. Delivered near real-time transaction visibility and enabled fraud detection models.
- Phase 4 - MVP: Acquiring Analytics (9 months): Scaled platform to merchant acquiring domain – onboarded transaction and merchant master data, extended tokenization rules, built acquiring-specific analytical models, enabled cross-business analytics linking issuing and acquiring for comprehensive customer insights.
- Phase 5 - Hardening & Enterprise Scaling (17 months): Onboarded additional business domains (retail banking, corporate banking, risk), optimized Spark jobs achieving 20-30% cost reduction, implemented auto-scaling policies, strengthened data lineage and metadata management, conducted security audits, decommissioned legacy Oracle databases.