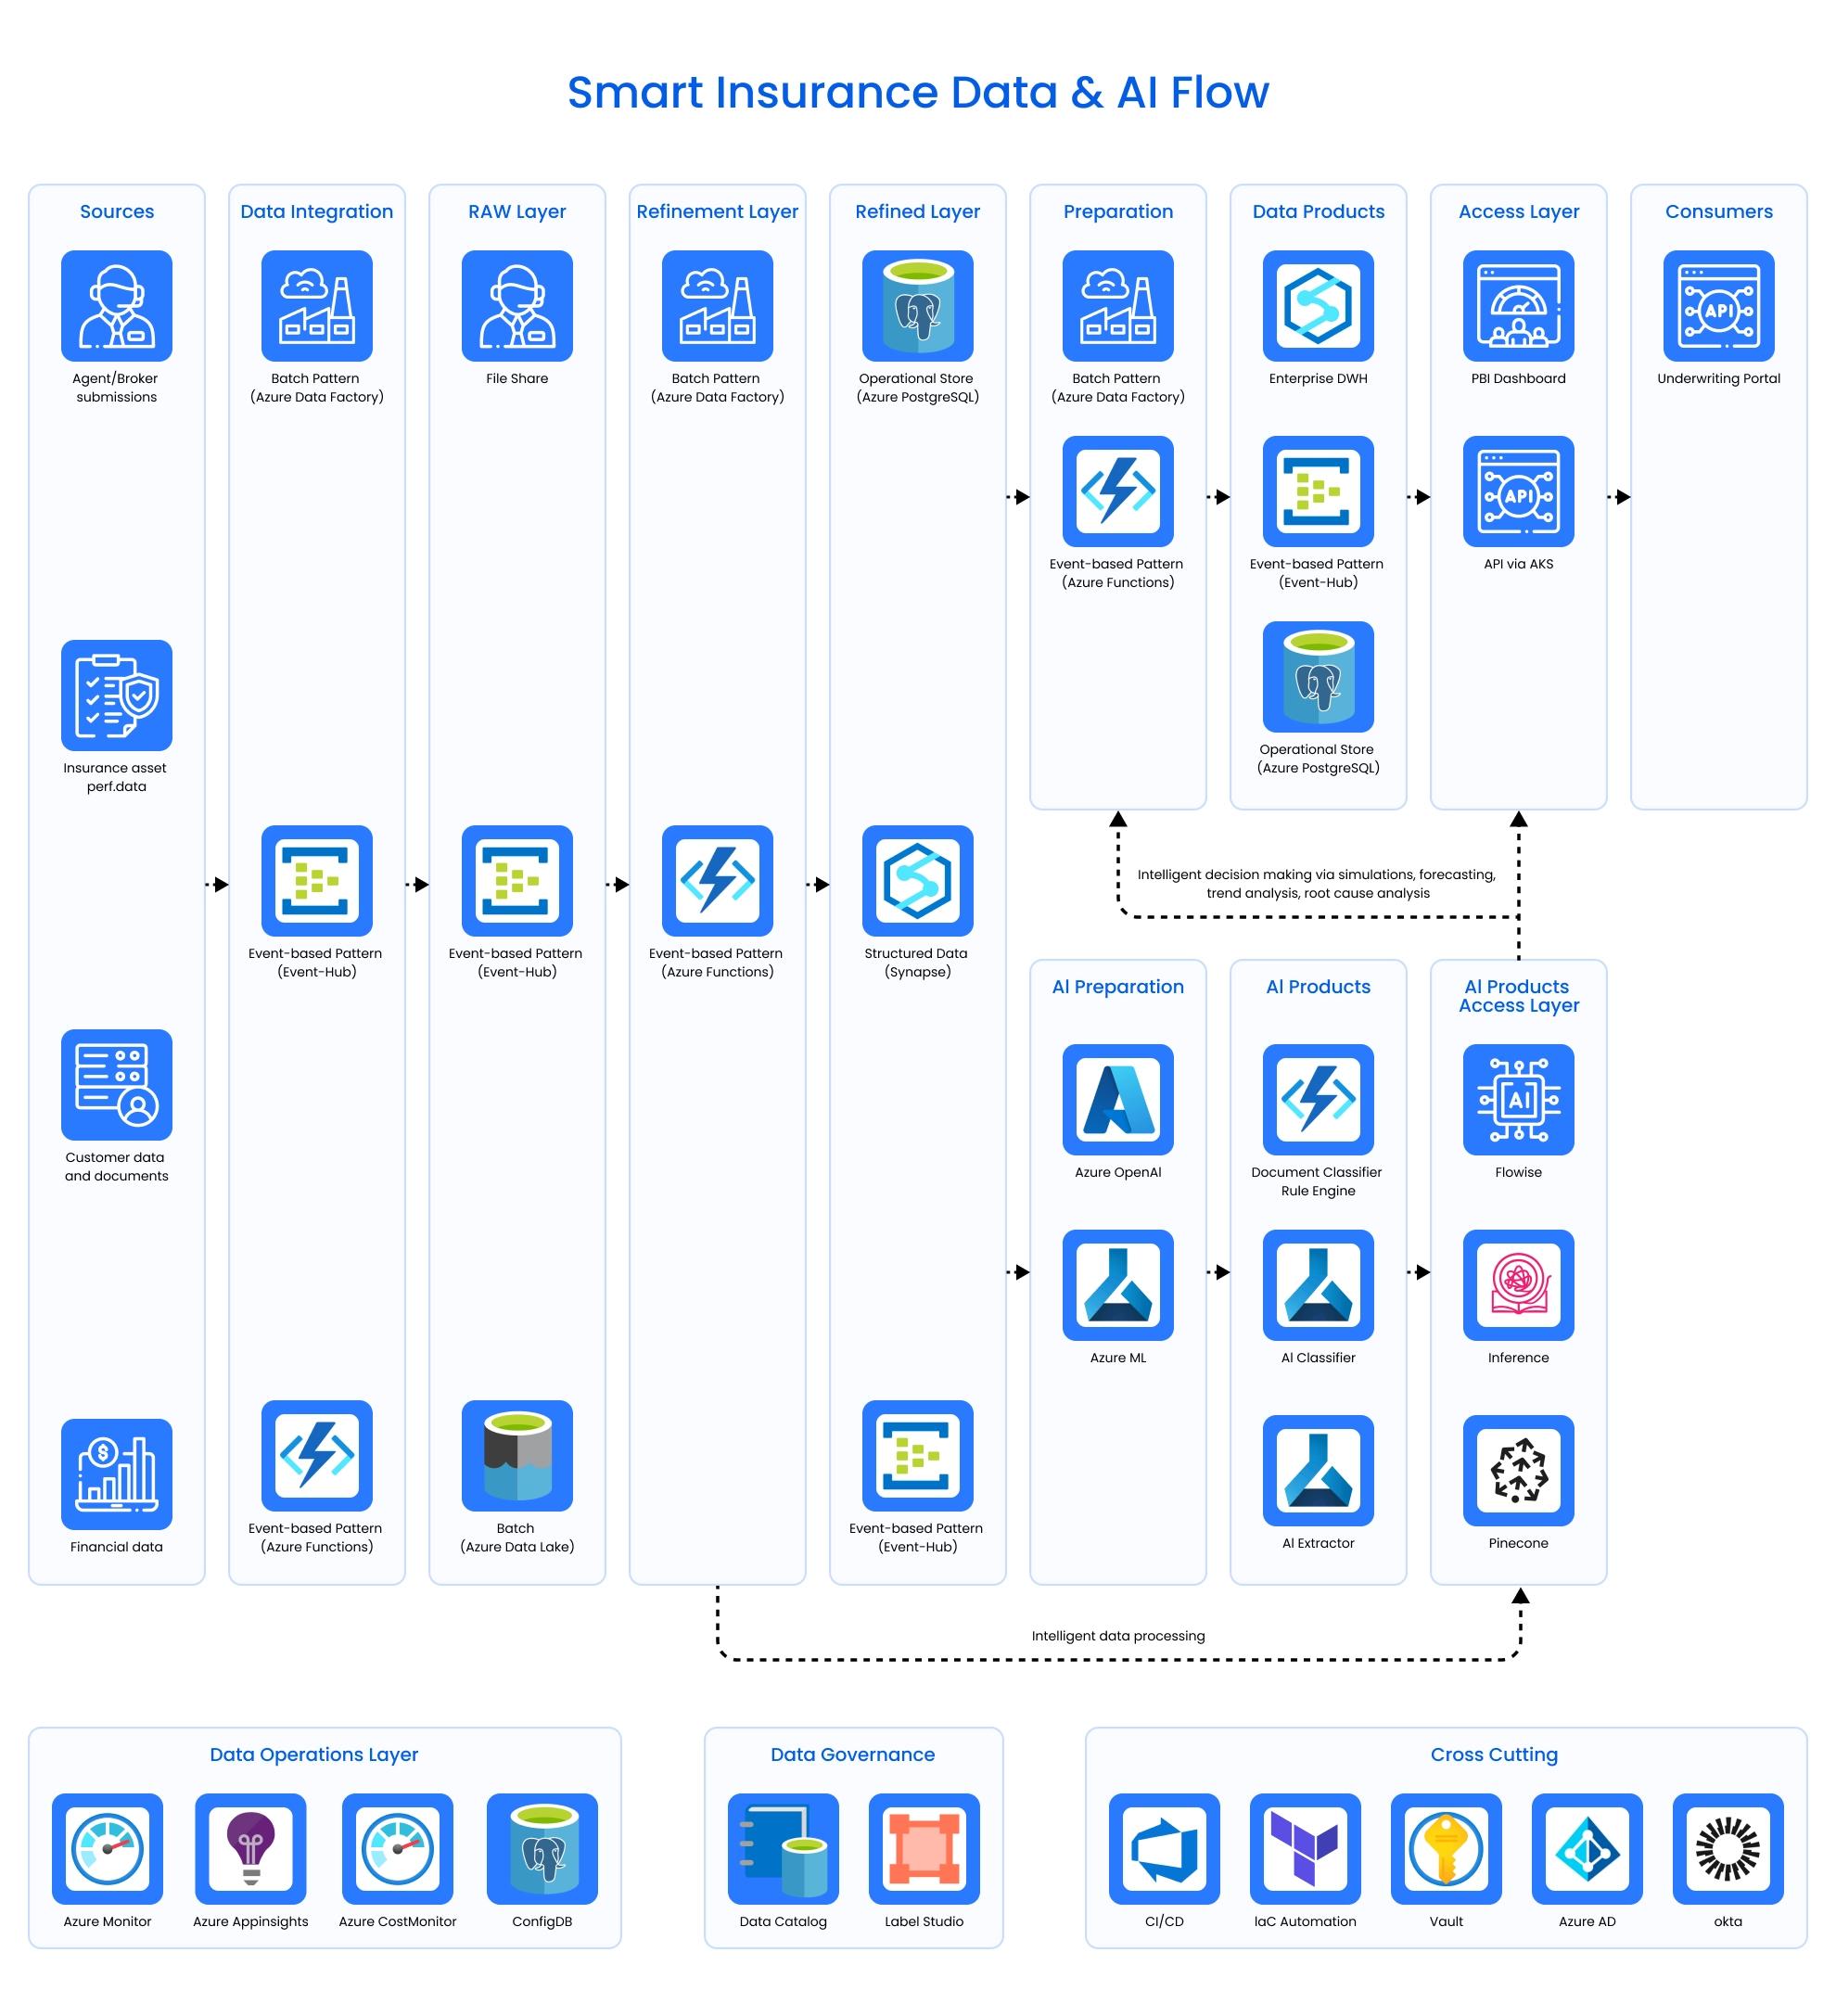
Understanding that no off-the-shelf solution existed for this level of document variety and processing complexity, Binariks designed a comprehensive approach:
Discovery & Team Assembly
We assembled specialists who underwent rigorous external and internal interviews, ensuring expertise in both insurance domain knowledge and cutting-edge AI technologies. Our team included data scientists familiar with unstructured document processing, Azure architects, and insurance industry veterans.
Problem Framing & Solution Architecture
Through intensive discovery sessions, we identified that the client lacked labeled datasets—a critical requirement for AI model training. We developed a custom tool to select documents with varied structures, ensuring balanced training and testing datasets while maintaining data quality standards.
Phased Implementation Strategy
Rather than attempting a big-bang transformation, we structured the project in phases:
- PoC for validation (2 months)
- Data Platform MVP (9 months)
- AI Classification & Extraction MVP (7 months)
- UAT and optimization (1 month)
This approach allowed for continuous validation, risk mitigation, and iterative improvement while delivering value at each milestone.